
Google, Yapay Zeka İçeriklerini Tanıyan SynthID Detector Aracını Yayınladı
Google, yapay zeka ile üretilen içerikleri tespit eden SynthID Detector aracını yayınladı. Sistemin çalışma prensibi, avantajları ve teknik kısıtlamalarını inceleyin.
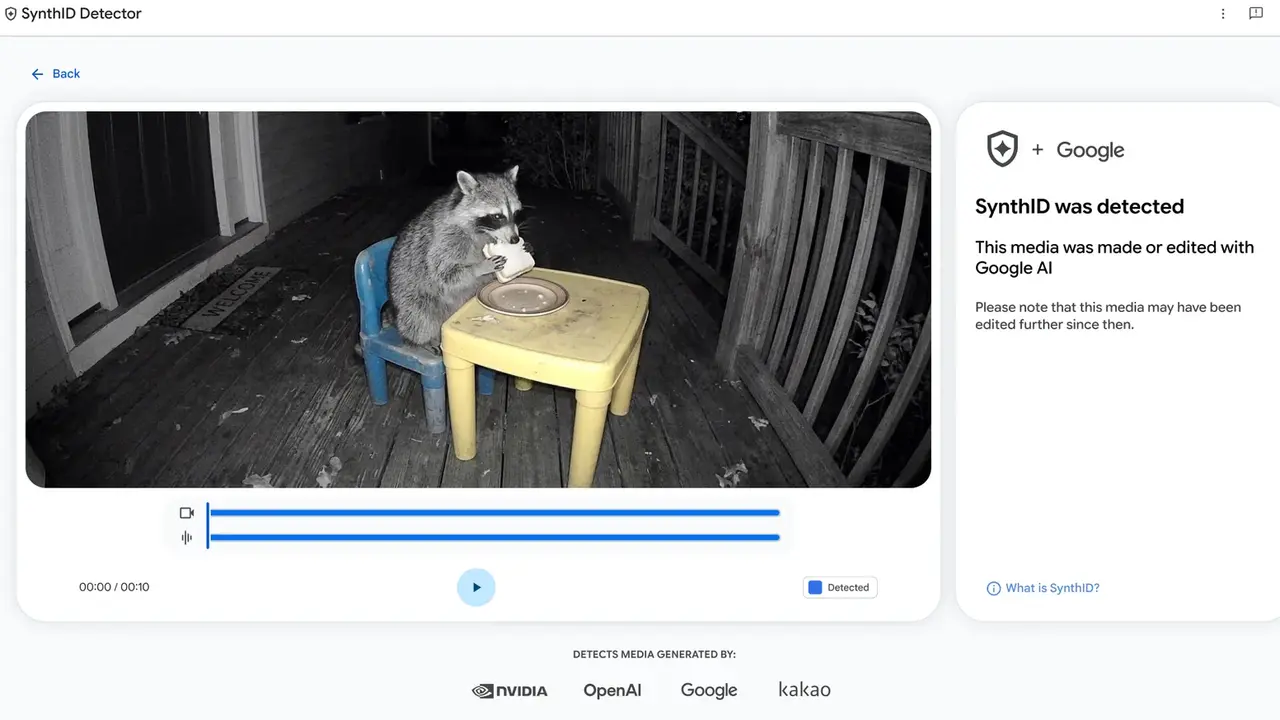
Google, yapay zeka tarafından oluşturulan veya düzenlenen video, ses ve görsel içerikleri tespit etmek amacıyla geliştirdiği SynthID Detector aracını bugün daha geniş bir kullanıcı kitlesine açtığını duyurdu. Web tabanlı bu servis, Google, OpenAI, Nvidia ve Kakao gibi büyük teknoloji şirketlerinin modelleriyle üretilen içeriklerdeki görünmez filigranları tanımlayabiliyor. Kullanıcıların Google, OpenAI veya Apple hesaplarıyla giriş yaparak erişebildiği SynthID Detector, yapay zeka tarafından üretilen materyallerin şeffaflığını artırmayı hedefleyen önemli bir adım olarak öne çıkıyor. Önümüzdeki haftalarda Apple'ın Image Playground gibi araçlarıyla oluşturulan görsellerin de sisteme dahil edilmesiyle kapsamın genişletilmesi planlanıyor.
- Google, yapay zeka içeriklerini tanımlayan SynthID teknolojisini web tabanlı bir hizmet olarak erişime açtı.
- Hizmet, OpenAI, Nvidia ve Kakao gibi farklı şirketlerin modelleriyle oluşturulan içerikleri tespit edebiliyor.
- Sistem, sadece SynthID filigranı içeren içerikleri tanımlayabildiği için sınırlı bir başarı oranına sahip bulunuyor.
- Sektördeki farklı standartlar nedeniyle evrensel bir tespit yöntemi henüz geliştirilemedi.
SynthID Detector Teknolojisinin Sınırları Belirginleşiyor
Google, 2023 yılında tanıttığı SynthID teknolojisiyle yapay zeka tarafından üretilen içeriklere dijital ve gözle görülmeyen bir imza eklemeye başlamıştı. Ancak bu filigranların tespit edilebilmesi için özel yazılımlara ihtiyaç duyulması, teknolojinin halka yayılımını kısıtlıyordu. Yeni yayınlanan araç, bu engeli aşmak adına daha kullanıcı dostu bir arayüz sunsa da, sistemin önemli teknik kısıtlamaları bulunuyor. En büyük sorun, aracın yalnızca SynthID filigranı eklenmiş içerikleri tanıyabilmesidir. Anthropic'in Claude modeli, xAI'ın Grok chatbot'u veya birçok açık kaynaklı Çin menşeli yapay zeka modeli bu filigran standardını kullanmamaktadır. Dolayısıyla, internette dolaşan çok sayıda yapay zeka üretimi içerik, bu tespit aracı tarafından tamamen göz ardı edilmektedir. [image_1]İçerik Analizinde Teknik Zorluklar Yaşanıyor
SynthID Detector'ın bir diğer önemli eksikliği, görsel veya işitsel bir dosyanın tamamen mi yapay zeka ile üretildiğini yoksa sadece kısmen mi düzenlendiğini ayırt edememesidir. Bir içerik üzerinde yapılan kısmi yapay zeka müdahaleleri, sistem tarafından net bir şekilde ayrıştırılamamakta ve bu durum doğrulama süreçlerinde kafa karışıklığı yaratmaktadır. Meta gibi diğer teknoloji devleri de kendi su işaretleme sistemlerini geliştirse de, bu sistemler genellikle üçüncü taraf modellerle uyumsuz çalışmaktadır. Sektörde bir bütünlük sağlanmadığı sürece, yapay zeka tarafından üretilen içeriklerin %100 doğrulukla tespit edilmesi teknik olarak imkansız görünmektedir. [image_2]Endüstriyel Standartlar İçin İş Birlikleri Geliştiriliyor
Google, bu zorlukların farkında olduğunu belirterek, tespit yeteneklerini geliştirmek için farklı ortaklıklar kurmaya devam ettiğini açıklamaktadır. Şirket, yapay zeka ekosisteminde su işaretleme, meta veri standartları ve doğrulama araçlarının bir arada çalıştığı katmanlı bir yapının kurulması gerektiğini savunmaktadır. Google'ın teknoloji dünyasındaki mevcut etkisi göz önüne alındığında, bu evrensel standardın oluşturulması konusunda en kritik rolü üstlenebileceği tahmin edilmektedir. Teknolojinin gelişimi ve yaygınlaşmasıyla birlikte, yapay zeka tarafından oluşturulan içeriklerin tespit edilebilirliği konusunda daha güvenilir yöntemlerin ortaya çıkması beklenmektedir. Ancak şimdilik, kullanıcıların dijital içeriklere karşı her zaman temkinli yaklaşması gerektiği vurgulanmaktadır.Sizce yapay zeka tarafından üretilen içerikleri tespit etmek için dünya genelinde tek bir standart oluşturulabilir mi, yoksa bu teknolojik rekabet nedeniyle imkansız mı görünüyor? Düşüncelerinizi yorum bölümünde bizimle paylaşın.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Bu gelişme hakkında sen ne düşünüyorsun?
Yorumlar
İlk yorumu siz yazın.