
Co-Design Bench'te kodlama ajanları zorlandı
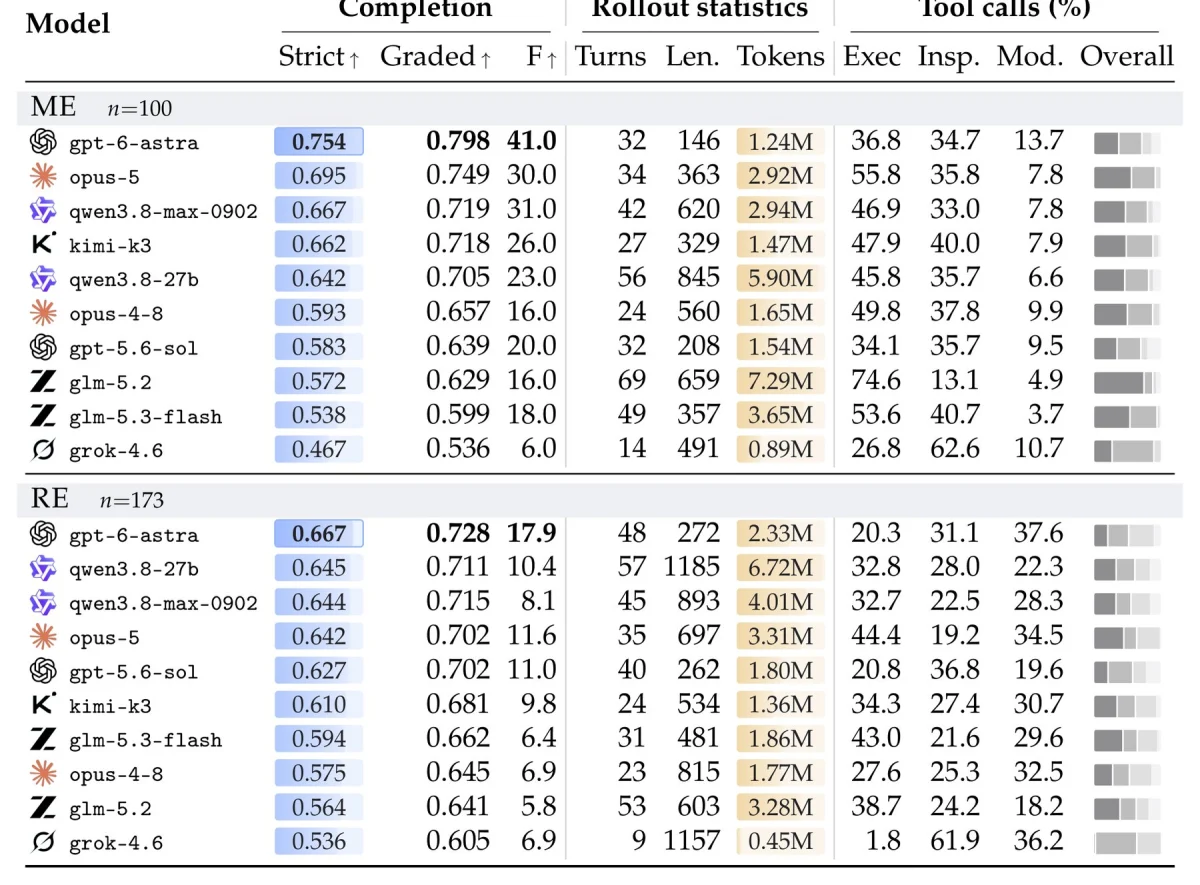
Alibaba araştırmacılarının da yer aldığı ekibin Co-Design Bench testinde GPT-6 Astra, görevlerin yalnızca yüzde 26,4'ünü tamamen doğru çözdü.
- Alibaba ve Asya üniversitelerinden araştırmacılar, gerçek kullanıcı taleplerinden Co-Design Bench adlı kodlama ajanı testini geliştirdi.
- En iyi model GPT-6 Astra, gereksinimlerin ortalama yüzde 70'ini karşılıyor ama görevlerin yalnızca yüzde 26,4'ünü tamamen doğru çözüyor.
- Aynı model farklı çalışma ortamlarında farklı sonuç verdiği için araştırmacılar model ve ortamın birlikte raporlanmasını öneriyor.
Alibaba ve birkaç Asya üniversitesinden araştırmacılar, kodlama ajanlarını gerçek taleplerle sınamak için Co-Design Bench adlı yeni bir test geliştirdi. Test edilen on modelden en iyisi olan GPT-6 Astra, bir görevin gereksinimlerinin ortalama yüzde 70'ini karşılıyor. Ancak sonucun tamamen doğru çıktığı görev oranı yalnızca yüzde 26,4.
Testte ajanlar, mevcut web uygulamalarını kullanıcı taleplerine göre yeniden düzenliyor. Girdi bazen görsel, ses kaydı, video ya da belge oluyor. Ajan çoğu durumda işin büyük kısmını hallediyor, ama en az bir ayrıntıyı eksik bırakıyor. Bu yüzden bu araçları kullanan kişi neredeyse her seferinde elle düzeltme yapmak zorunda kalıyor.
Co-Design Bench Neden Geliştirildi?
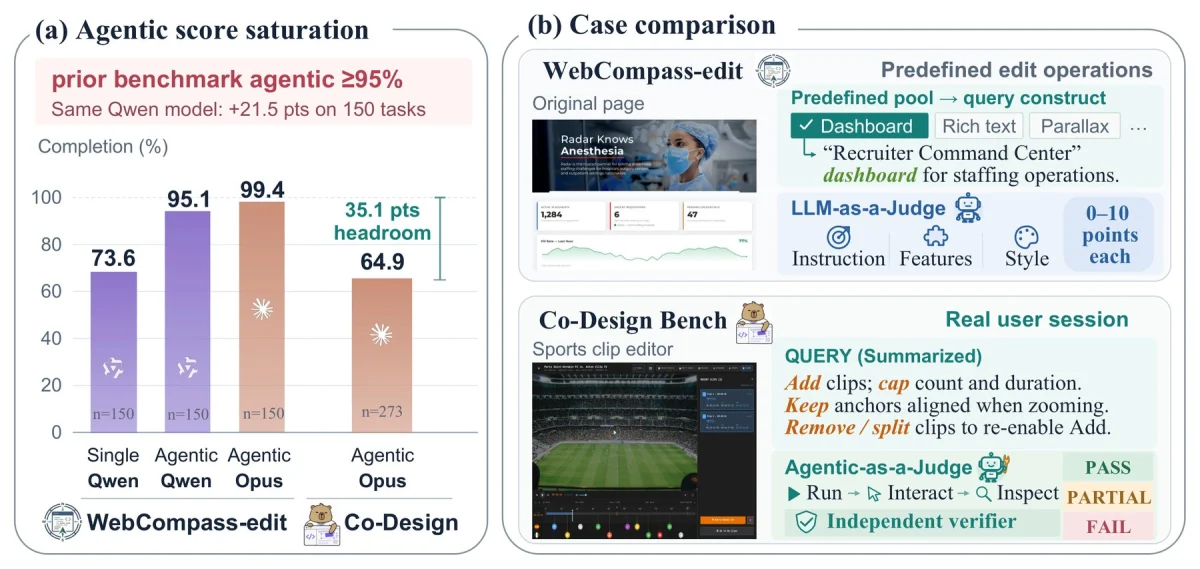
Yazarlar yeni testin gerekçesi olarak mevcut ölçütlerin doygunluğa ulaşmasını gösteriyor. Modeller kendi kodunu çalıştırıp denetleyebildiğinde ve hatalarını düzeltebildiğinde, bu testlerde yüzde 99'un üzerinde puan alıyor. Dolayısıyla modeller arasındaki farkı ölçmek neredeyse imkansız hale geliyor.
WebCompass-edit gibi eski testlerde kodlama ajanları neredeyse kusursuz puan alıyor. Co-Design Bench'te ise aradaki fark 35 puanı aşıyor.
Yeni test, gerçek kodlama oturumlarında gelen taleplere dayanıyor. Ekip, kullanıcının isteğini birkaç kez yeniden yazmak ya da değişiklikleri geri almak zorunda kaldığı örnekleri öne çıkardı. Böylece testte, pratikte yapay zeka ajanlarını zaten zorlamış görevler ağırlık kazandı. Bunlar arasında makbuzdan bir tutarı alıp bağlı tüm toplamları güncellemek gibi küçük işler var. Projenin baştan sona elden geçirilmesi gibi büyük işler de listede yer alıyor.
Çok kipli kolda ajanların makbuz, tablo ya da videodan değerleri çıkarıp bağlı tüm ekranları tutarlı biçimde güncellemesi gerekiyor.
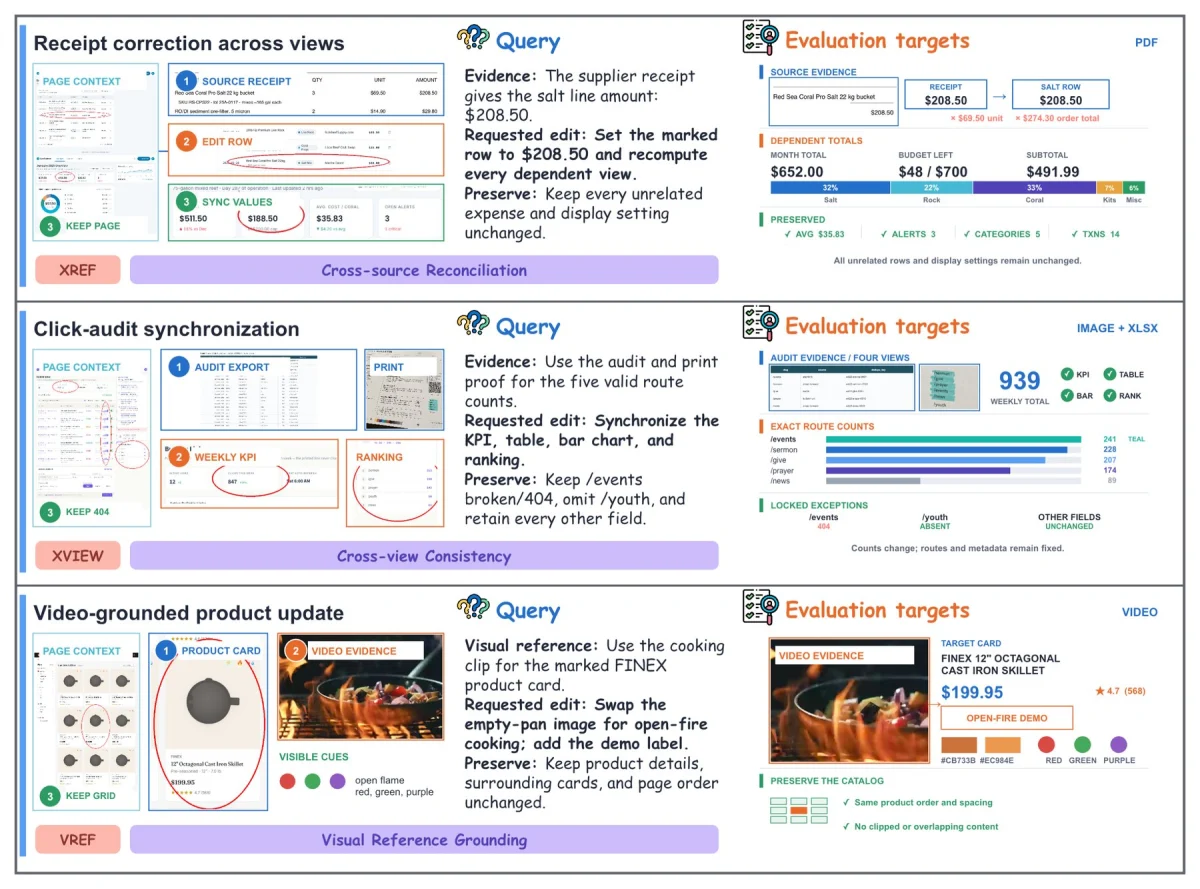
Puanlama da buna uygun biçimde sıkı. Bir yapay zeka hakem, bitmiş uygulamayı tarayıcıda deniyor. Ardından ikinci bir hakem olumlu her kararı yeniden kontrol ediyor; ayrıca maket ya da koda gömülmüş sonuç arıyor. Puan yalnızca uygulamada gerçekten çalışan özelliklere veriliyor.
Sıralamada Kim Önde, Modeller Nerede Zorlanıyor?
GPT-6 Astra'nın ardından Claude Opus 5 ve Qwen3.8-Max geliyor. Grok 4.6 ise son sırada yer alıyor. Büyük elden geçirmelerde çok daha küçük olan Qwen3.8-27B ikinci sıraya çıkıyor. Yine de yazarlar bu sonuçtan modelin genel bir üstünlüğü olduğu yargısına varmıyor.
Bir görev düzen, tasarım, etkileşim ve içerik gibi birden fazla değişiklik türünü birleştirdikçe tüm modellerin performansı düşüyor. Oysa gerçek projelerde iç içe geçmiş gereksinimler olağan durum.
On modelin tamamı, görev üç ya da dört farklı değişiklik türü istediğinde daha düşük puan alıyor.
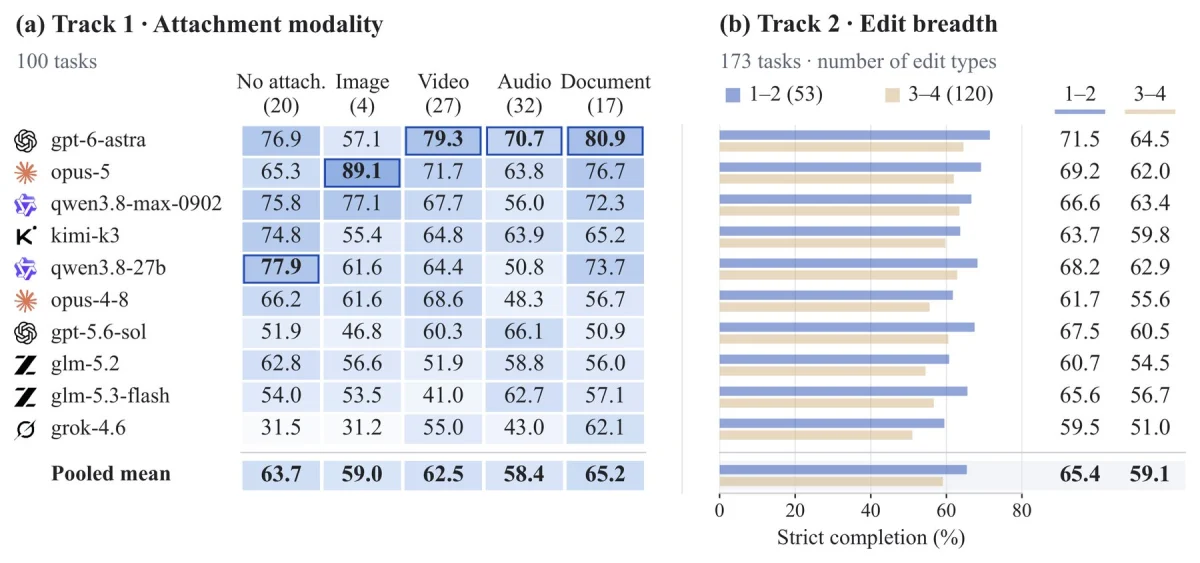
Ek hesaplama gücü bu zayıflığı pek gidermiyor. GLM-5.2, küçük değişikliklerde GPT-6 Astra'dan yaklaşık altı kat fazla token harcıyor. Buna karşın belirgin biçimde daha düşük puan alıyor.
GPT-6 Astra her iki kolda da önde. Ama çok kipli görevlerin yüzde 41'ini, depo görevlerinin ise yüzde 18'in biraz altındaki kısmını tam çözebiliyor.
Çalışma Ortamı da Model Kadar Belirleyici
Araştırmacılar aynı modelleri farklı çalışma ortamlarında da denedi. Çalışma ortamı, yani ajanın kodu okuyup yazdığı ve çalıştırdığı program, sonucu ciddi biçimde değiştiriyor. Örneğin Qwen3.8-27B büyük elden geçirmelerde ortama göre yüzde 75 ya da yalnızca yüzde 56 puan aldı. İki modelden hangisinin önde çıkacağı da ortama bağlı.
Bu nedenle yalnızca modeli listeleyen sıralamalar resmin bir parçasını gösteriyor. Yazarlar, model ile çalışma ortamının birlikte raporlanmasını öneriyor. Kodlama ajanı seçen şirketler için bunun anlamı net: iki bileşeni bir çift olarak test etmek gerekiyor.
Test ayrıca bazı sınırlar taşıyor. Her görev için tek bir sabit talep değerlendiriliyor; kullanıcının sonradan sorduğu sorular ya da görev ortasındaki düzeltmeler teste dahil değil. Üstelik yapay zeka hakemler de hata yapabiliyor.
Araştırma kuruluşu METR'in bir çalışması, test puanlarıyla gerçek kullanım arasındaki uçurumu zaten göstermişti. Proje yöneticilerinin yapay zeka kodunu fiilen kabul oranı, yaygın kullanılan SWE-bench Verified puanlarının yaklaşık 24 puan altında kaldı. Test ortamlarındaki kusurlar da ajanların görevi çözmeden geçmesine yol açabiliyor.
Çalışma ortamının etkisi ise tek yönlü değil. Kodlama ajanları üzerine yakın tarihli bir çalışma, üç kata kadar fazla token harcayan daha karmaşık ortamlardan neredeyse hiç ölçülebilir fayda görmedi.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Bu gelişme hakkında sen ne düşünüyorsun?
Yorumlar
İlk yorumu siz yazın.