
LongCat-2.5 ve Meituan'ın donanım tercihi
Meituan, LongCat-2.5 modelinin ağırlıklarını MIT lisansıyla yayımladı. 1,6 trilyon parametreli model Çin donanımında eğitildi.
- Meituan, 1,6 trilyon parametreli LongCat-2.5 modelinin ağırlıklarını MIT lisansıyla yayımladı.
- Model tamamen Çin donanımında eğitildi; örnek kurulum 194 Huawei Ascend çipi kullanıyor.
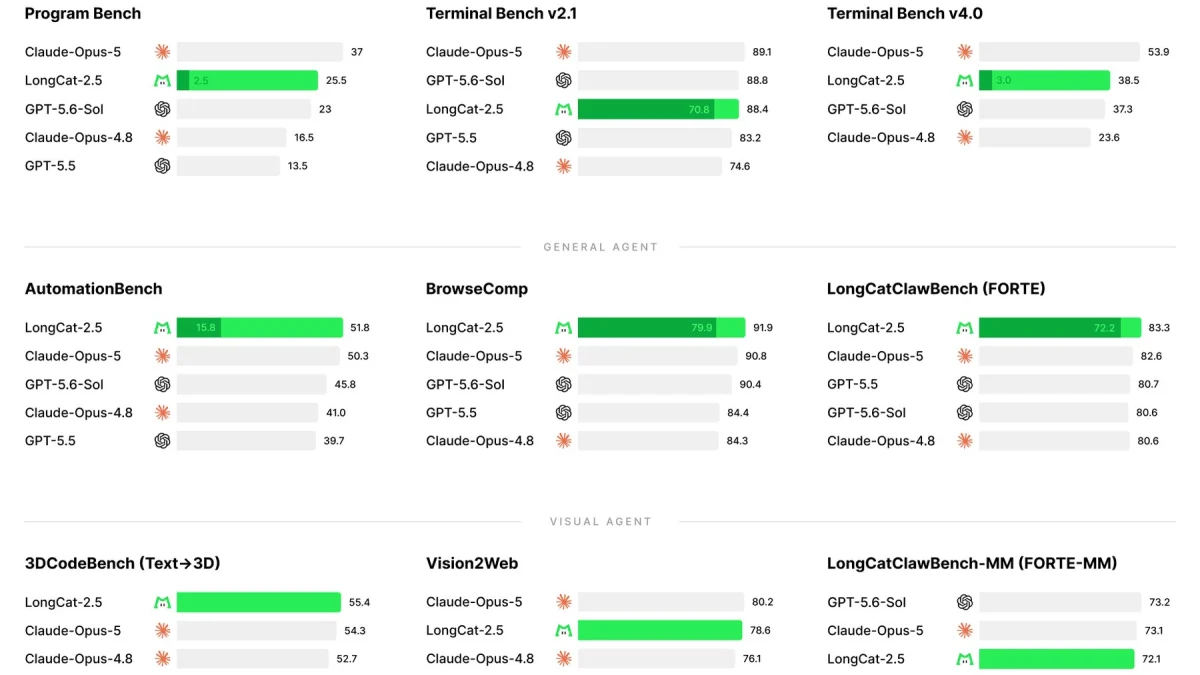
- Terminal Bench v2.1'de 88,4 puan alan model, Claude Opus 5'in 89,1 puanına yaklaşıyor.
Meituan, yapay zeka ajanları için geliştirdiği LongCat-2.5 modelinin ağırlıklarını yayımladı. 1,6 trilyon parametreli model, hiç Nvidia GPU'su görmeden tamamen Çin donanımında eğitildi. Buna karşın DeepSWE testinde tablodaki modellerin neredeyse hepsinin gerisinde kaldı.
Çinli yemek teslimat şirketi Meituan'ın LongCat ekibi, modeli resmen tanıttıktan bir hafta sonra ağırlıkları, yani eğitilmiş modelin kendisini paylaştı. LongCat-2.5, uzun ve çok adımlı işleri kendi başına yürüten ajanlar için geliştirildi; özellikle kodlamayı hedefliyor. Meituan'a göre model birçok testte batılı üst düzey modellere yaklaşıyor.
Model bir uzmanlar karışımı (mixture-of-experts) yapısında. Her token için, yani modelin işlediği her metin parçası için, uzman alt ağların yalnızca bir kısmı çalışıyor. 1,6 trilyon parametrenin yaklaşık 48 milyarı devrede. API üzerinden tek seferde bir milyon token işleyebiliyor, 128 bin token uzunluğunda yanıt üretiyor. Metin, görsel ve video anlıyor; yanıtı metin olarak veriyor. Kullanıcı muhakemeyi (reasoning) açıp kapatabiliyor.
LongCat-2.5 görüntüyü token'a çeviriyor
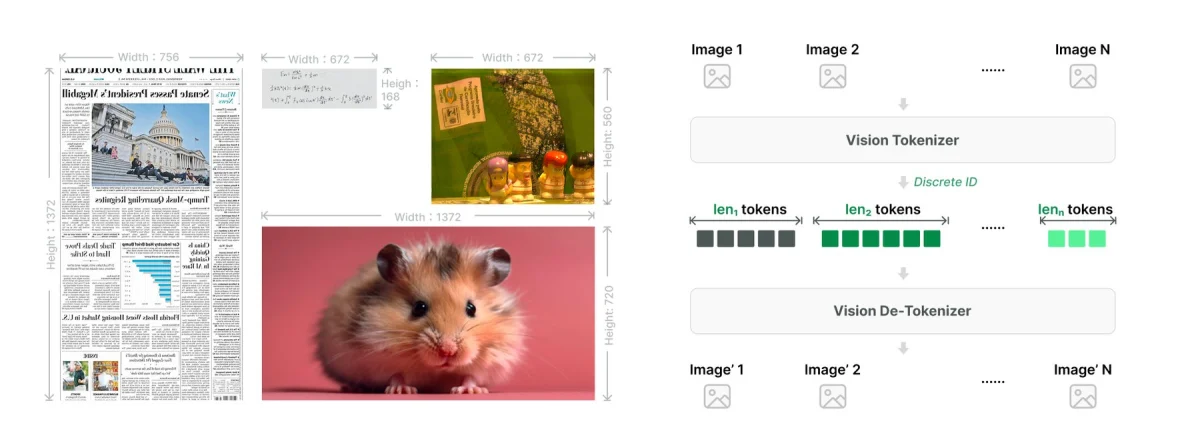
Model, selefi LongCat-2.0'ın üzerine kuruldu ve görsel anlama yeteneği ekledi. Birçok çok modlu model, görüntü için sonradan eklenen ayrı bir kodlayıcı kullanıyor. LongCat-2.5 ise görüntüleri token'a çevirip metinle birlikte aynı yapıda işliyor.
Yaklaşım, araştırma modeli LongCat-Next'e dayanıyor. Hedef; görsel kodlama, tasarım ve 3B görevlerde başarıyı artırmak. Görüntüler özgün çözünürlüğünde ayrık token'lara bölünüyor.
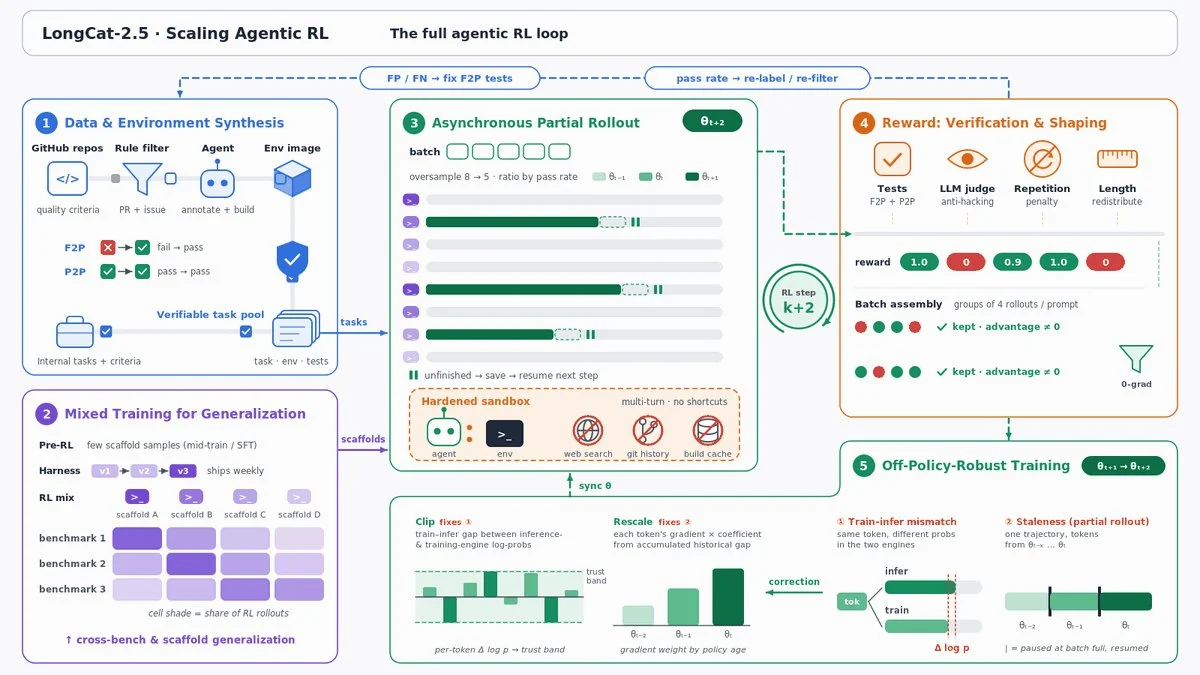
Pekiştirmeli öğrenmede ekip, GitHub çekme isteklerinden alınan gerçek yazılım görevlerini ve yeniden kurgulanan ajan hatalarını kullandı. Modelin görevleri gerçekten çözdüğünden emin olmak için eğitim ortamlarında internet erişimini kapattı, Git geçmişini ve önbelleği sildi. Çözümlerde hile olup olmadığını bir dil modeli denetledi. Ayrıca ajan işleri, muhakeme ve diyalog için eğitilmiş birkaç uzman öğretmen modelin yetenekleri bu modele aktarıldı.
Çin çipleri için hazırlandı
Meituan, uzmanların ağırlıklarını ve aktivasyonlarını 4 bit hassasiyete indiriyor. Çin çipleri bu biçimi doğrudan işleyebiliyor. Şirketin yük testlerinde 8 bit sürüme göre istem işleme hızı yüzde 43,3, yanıt üretme hızı yüzde 42,77 arttı. Meituan, doğruluğun sıkıştırılmamış modelle aynı düzeyde kaldığını söylüyor.
LongCat-2.5'in bu sürümü ayrı bir depoda duruyor. Kendi sunucusunda çalıştırmak isteyenler için hazırlanan rehber, Huawei Ascend Atlas A2 serisinden 194 hızlandırıcılık bir kümeyi tarif ediyor. İkisi görüntü işlemeye, 64'ü istem almaya, 128'i yanıt üretmeye ayrılıyor. Nvidia GPU'lar için bir yönerge yok.
Meituan, selefi LongCat-2.0'ı haziran sonunda, 50 binden fazla Çin yapımı yapay zeka çipinden oluşan bir kümede eğittiğini söylüyor. Model bundan önce OpenRouter'da “Owl Alpha” adıyla anonim olarak çalışıyordu.
Kimi K3.1 ve GLM-5.3 gibi Çin'in açık ağırlıklı modelleri, yaygın testlerde ABD'nin en iyi modellerine büyük ölçüde yetişti. Baştan Çin çiplerine göre ayarlanan modeller, bu donanımı Çin dışında da daha çekici kılıyor. Şirketin daha önce yayımladığı LongCat-Image ise yalnızca 6 milyar parametreli, açık kaynak bir metinden görsele modeli.
Terminal testinde Opus 5'in hemen arkasında
LongCat ekibi, komut satırı görevlerinde ajanların başarısını ölçen Terminal Bench v2.1'de 88,4 puan aldığını bildiriyor. Meituan'ın tablosunda Claude Opus 5 89,1, GPT-5.6 Sol 88,8 puanda. Zirvede 90,6 ile DeepSeek-V4.1-Flash var.
DeepSWE, modellerin gerçek kod depolarındaki hataları ne kadar iyi düzelttiğini ölçüyor. Model burada selefinin 9,7 puanını 64,6'ya çıkardı. Lider 74,2 ile DeepSeek-V4.1-Flash, GPT-5.6 Sol ise 72,7 puanda. Daha yeni Claude Opus 5.5 ve GPT-6.1 Sol tabloda yok.
Daha zor sürüm Terminal Bench v4.0'da model 38,5 puan aldı. Bu, GPT-5.6 Sol'un 37,3'ünün biraz üstünde, Opus 5'in 53,9'unun ise epey altında. Web arama testi BrowseComp'ta 91,9 ile tablonun en yüksek puanına ulaştı; Meituan bu testi kendi ortamında çalıştırdı.
Ağırlıklar, ticari kullanıma, değiştirmeye ve yeniden dağıtıma izin veren MIT lisansıyla açık. Kullanıcılar modeli LongCat'in sohbet arayüzünde de deneyebiliyor. API, OpenAI ve Anthropic formatlarını destekliyor; Claude Code, Codex ve Hermes gibi ajan altyapılarına bağlanıyor. Lansmana özel, sınırlı süreli fiyat milyon girdi token'ı için yaklaşık 0,27 euro, milyon çıktı token'ı için yaklaşık 1,07 euro.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Bu gelişme hakkında sen ne düşünüyorsun?
Yorumlar
İlk yorumu siz yazın.