
Google TPU 8i Max ve 8tx çipleri tanıtıldı
Google, TPU 8i Max ve TPU 8tx çiplerini tanıttı. 8i Max, 8i'ye göre hesaplama ve belleği ikiye katlarken 8tx gizli çıkarım için geliştirildi.
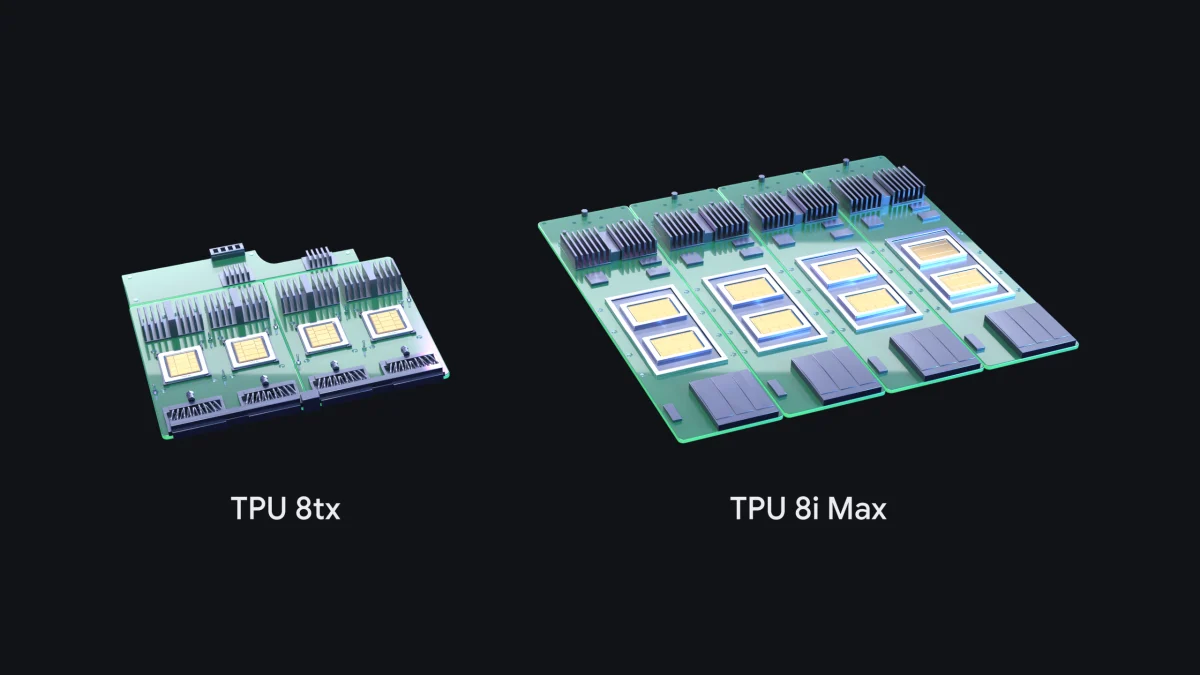
- Google, sekizinci nesil TPU ailesine TPU 8i Max ve TPU 8tx çiplerini ekledi.
- TPU 8i Max, 8i'ye göre hesaplama gücünü, SRAM'i ve yüksek bant genişlikli belleği ikiye katlıyor.
- TPU 8tx, düzenlemeye tabi kurumlar için hassas verileri ve model ağırlıklarını donanım düzeyinde yalıtıyor.
Google, sekizinci nesil TPU ailesine TPU 8i Max ve TPU 8tx adlı iki yeni yapay zeka çipi ekledi. TPU 8i Max, 8i'ye göre hesaplama gücünü, SRAM'i ve yüksek bant genişlikli belleği ikiye katlıyor. Asıl sürpriz hızda değil gizlilikte: TPU 8tx, veriyi model işlerken bile korumayı hedefliyor.
Nisan ayındaki Google Cloud Next 2026'da şirket aynı nesilden iki özel çip tanıtmıştı: büyük ölçekli eğitim için 8t ve gerçek zamanlı akıl yürütme için 8i. Çiplerin görevi iki ana işi karşılamaktı: modelleri geliştirmek ve çalıştırmak. Şimdi aile, ek sistemlere doğru genişliyor.
TPU 8i Max, çok geniş bağlam pencereleri ve raf başına en yüksek hesaplama yoğunluğu için tasarlandı. TPU 8tx ise güvenli ve gizli çıkarım işine odaklanıyor.
TPU 8i Max ve bellek darboğazı
Google'a göre TPU 8i Max, işlemcilere veriyi dışarı taşımadan çalışabilecekleri en geniş belleği vermeyi amaçlıyor. Çip, aynı raf alanına iki kat silikon sığdırıyor. Böylece veri merkezinde metrekare ve watt başına kaplanan alan azalıyor.
Bağlam penceresi, bir yapay zeka modelinin yanıt verirken değerlendirebildiği veri miktarını belirler. Geniş pencere; uzun bir belgeyi, konuşma geçmişini, ses dosyasını, videoyu ya da kod koleksiyonunu tek seferde ele almak demek. Ancak bunun bedeli var. Daha fazla bilgiyi işlemek ve tekrar tekrar taramak, çiplerden daha fazla veri alışverişi istiyor.
Bu da daha çok yonga üstü bellek ve işlemciler arasında veri taşıyan daha güçlü bağlantılar gerektiriyor. Yonga üstü belleği artırmak ise işlemciler arası veri taşıma ihtiyacını azaltıyor. Sonuçta gecikme düşüyor ve bir modelin bilgiyi ‘düşünürken’ harcadığı enerji azalıyor.
Google, çipi Gemini modelinin devasa bağlam pencerelerine yönelik çalışmasıyla birlikte geliştirdiğini söyledi. Gemini, sektör standardı olan 1 milyon token'ı destekliyor. Bu, yaklaşık 750 bin kelimeye ya da 1.500 sayfalık metne denk geliyor. Amiral gemisi modeller 1 milyon token'la çalışırken küçük modeller çoğunlukla 128 bin ile 256 bin token arasında kalıyor.
TPU 8tx ile gizli çıkarım
TPU 8tx, düzenlemeye tabi kurumlar ve hükümetler için optimize edildi. Hedef kitle, öncü ya da kendi geliştirdiği modelleri ve otonom ajanları en hassas verilerin yanında çalıştırmak isteyen kuruluşlar.
Veri normalde saklanırken ve ağ üzerinden gönderilirken şifreleniyor. Oysa bir yapay zeka modeli aynı veriyi işlerken şifresini çözmek zorunda. TPU 8tx, 8t ile aynı mimariye ve özel AMD işlemci ana sistemlerine dayanıyor. Donanım katmanına doğrudan yerleştirilmiş güvenli bir alan (secure enclave) hassas verileri ve model ağırlıklarını koruyup yalıtıyor.
Google'ın anlatımına göre mimari, eğitim seviyesindeki hesaplama gücünü hızlı çıkarımla birleştiriyor. Kurumlar modelleri tek bir gizli sistemde çalıştırabiliyor ve özelleştirebiliyor. Düzenlemeye tabi sektörler özel verilerle ince ayar yapabilir, büyük modelleri küçüklere damıtabilir ve ajanları pekiştirmeli öğrenmeyle eğitebilir.
Bunların hiçbiri verinin ayrı kümeler arasında taşınmasını gerektirmiyor. Böyle bir taşıma ise hassas bilginin sızma riskini doğurabilir.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Bu gelişme hakkında sen ne düşünüyorsun?
Yorumlar
İlk yorumu siz yazın.