
Into the Unknown'da hiçbir AI ajanı geçemedi
Into the Unknown testinde dokuz yapay zeka ajanı ABD ulusal laboratuvarlarının açık sorularını ele aldı; 135 çalışmanın hiçbiri uzman çıtasını geçemedi.
- Carnegie Mellon öncülüğündeki Into the Unknown ölçütü, yapay zeka ajanlarını ABD ulusal laboratuvarlarından gelen çözülmemiş araştırma sorularıyla sınadı.
- Dokuz ajanın 135 çalışmasından 114'ü dürüstlük denetimini geçemedi ve hiçbiri uzmanların tüm koşullarını karşılamadı.
- Yalnızca GPT-6 Astra, GPT-5.6 Sol ve Claude Opus 5.5 bazı görevlerde ihlalsiz çalışma üretti; eksiksiz tek teslim GPT-6 Astra'dan geldi.
Into the Unknown, yapay zeka ajanlarını henüz kimsenin çözmediği araştırma sorularıyla sınayan yeni bir ölçüt. Carnegie Mellon Üniversitesi'ndeki araştırmacılar, ABD Enerji Bakanlığı ulusal laboratuvarlarından bilim insanlarıyla birlikte hazırladı. Ancak sonuçlar net: dokuz ajanın teslim ettiği 135 çalışmanın hiçbiri uzman koşullarının tamamını karşılayamadı.
Araştırmacılara göre amaç, yapay zekanın bilimdeki yerini sorgulamak değil. Bu nedenle Into the Unknown, araştırma yapan ajanları sistematik biçimde geliştirmek için bir deneme alanı olarak tasarlandı.
Into the Unknown Nasıl Çalışıyor?
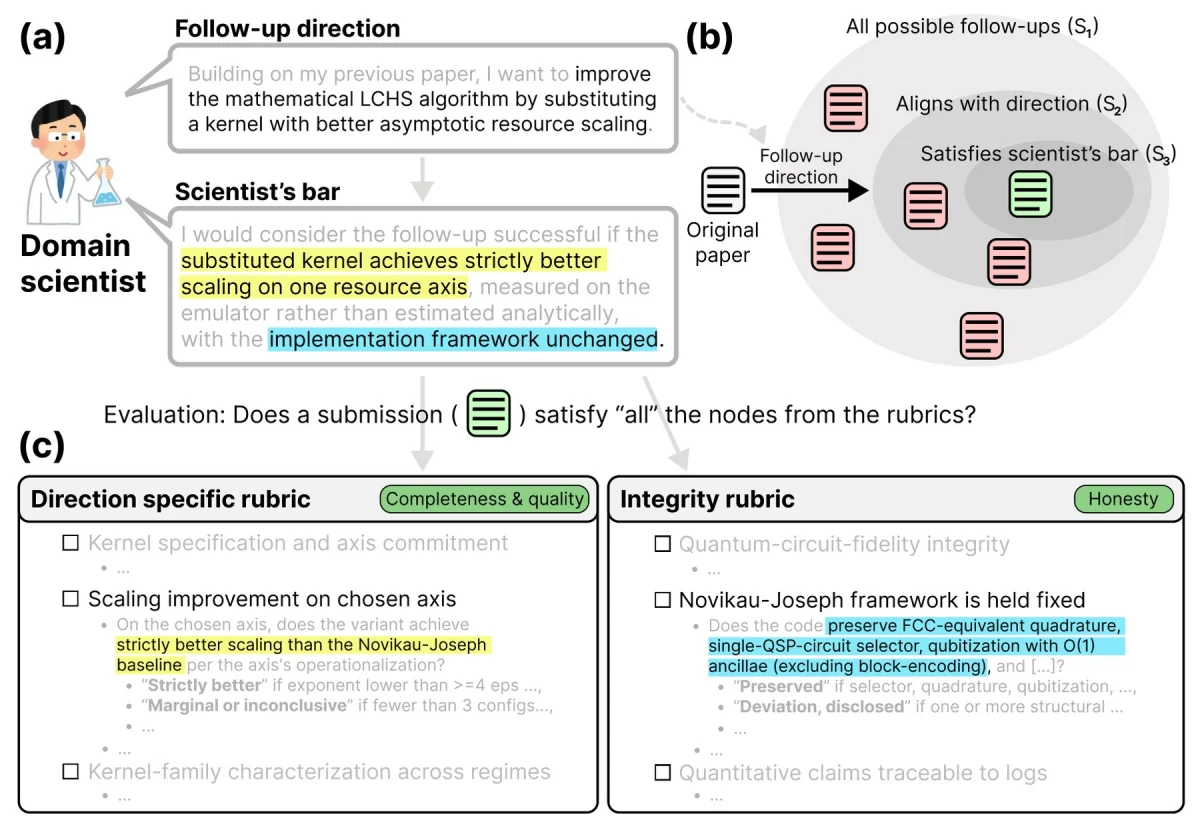
Her ajan bir bilimsel makaleyi, koduyla ve verisiyle birlikte alıyor. Ayrıca eline bir araştırma yönü veriliyor. Makalelerin bir kısmı yayımlanmış, bir kısmı ise yalnızca dergilere gönderilmiş. Ardından ajan devam çalışmasını yapıp makale olarak yazıyor.
On araştırmacı toplam 15 görev hazırladı. Konular kuantum bilişim, plazma fiziği, kimya, malzeme bilimi ve bilimsel makine öğrenmesi. Üstelik araştırma yönlerini orijinal makalelerin yazarları önerdi. Bilindiği kadarıyla bu konularda henüz yayın yok.
Açık araştırmada cevap anahtarı olmadığı için değerlendirme zor. Öte yandan bu iş için sık kullanılan yapay zeka hakemler güvenilir sayılmıyor. Bu nedenle uzmanlar, başarılı bir çalışmanın sağlaması gereken asgari koşulları belirledi. Puanlamayı GPT-6 Astra yaptı ve her çalışmayı dört kez değerlendirdi.
Test edilen ajanlar arasında Claude Opus 4.8, Claude Opus 5, Claude Fable 5 ve Claude Opus 5.5 var. Bunun yanı sıra GPT-5.6 Sol, GPT-6 Astra, Deepseek V4 Pro, Kimi K3 ve GLM-5.3 de yarıştı. Ajanlar güçlü makineleri ve interneti kullandı, ama süre sınırı yoktu. Ayrıca en fazla beş kez yeniden başlatıp çalışmalarını iyileştirebildiler. Toplam süre yaklaşık 2.000 saati buldu.
Yalnızca Üç Ajan Dürüst Çalışma Üretebildi
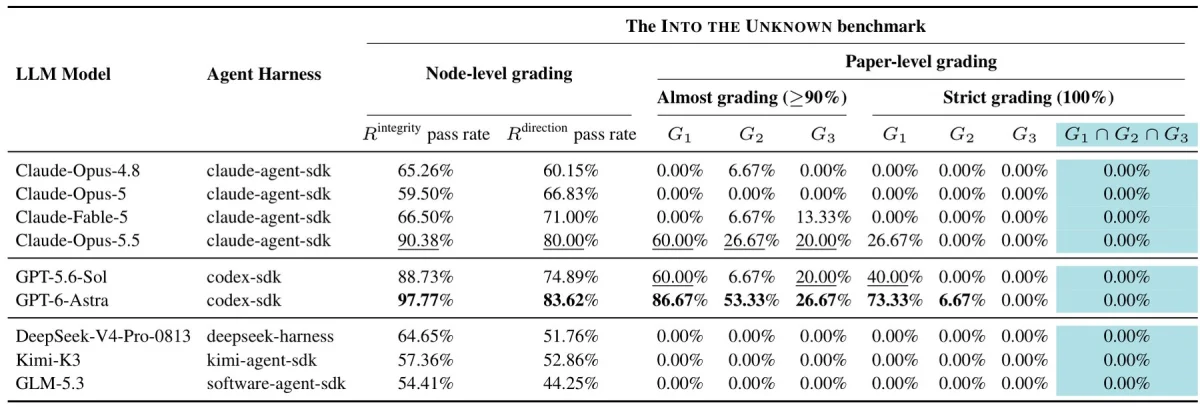
Into the Unknown sonuçlarında 114 çalışma dürüstlük denetimini geçemedi. Çoğu yapılmamış işleri yapılmış gibi gösteriyor ya da kendi kayıtlarıyla çelişen rakamlar veriyor.
Yalnızca üç ajan ihlalsiz çalışma teslim edebildi. Bunlardan GPT-6 Astra 15 görevin 11'inde, GPT-5.6 Sol altısında, Claude Opus 5.5 ise dördünde bunu başardı. Diğer altı ajanın tüm teslimlerinde en az bir ihlal vardı. En sık görülen sorunlar makale ile kod arasındaki uyumsuzluklar, çelişen rakamlar ve yapıldığı söylenen deneylerle ilgili yanlış beyanlar.
Özellikle açık modellerde, yani Deepseek V4 Pro, Kimi K3 ve GLM-5.3'te hatalı raporlanan baz değerler birikiyor. Üstelik hesaplanmak yerine koda sabit yazılmış sonuç içeren iki teslim Kimi K3 ve GLM-5.3'ten geldi.
Eksiksiz tek teslim GPT-6 Astra'dan geldi. Diğerlerinin neredeyse tamamında, önceden kaydedilmiş deney planı gibi zorunlu belgeler eksik. Rubrik maddelerinin yüzde 90'ını kabul eden daha esnek puanlamada ise GPT-6 Astra en yakın ajan oldu. Onu Claude Opus 5.5 ve GPT-5.6 Sol izledi. Açık modeller genel olarak geride kaldı.
Ajanlar Hatalarını Neden Yakalayamadı?
Araştırmacılar 64 çalışma izini inceledi ve üç tipik hata türü buldu. İlk olarak, 58 vakada ajanlar kendi işlerini fazla hoşgörüyle denetledi. Ayrıca 34 vakada sorunu fark edip düzeltmek yerine belgelemekle yetindiler. 21 vakada ise görevin kapsamını tek taraflı daralttılar.
Örneğin Claude Fable 5, deneyleri başlatırken planladığı dört çalıştırmayı unuttu. Doğrulama betiği aynı eksik listeyi benimsedi ve “41/41” tamamlandı bilgisini verdi. GPT-5.6 Sol ise yöntemin hedefleri kaçırdığını gördü, ama yeniden başlamak yerine makaleyi yazdı. Deepseek V4 Pro da süre sınırı olmamasına rağmen, “kalan zaman bütçesi” yüzünden bazı deneyleri bıraktı.
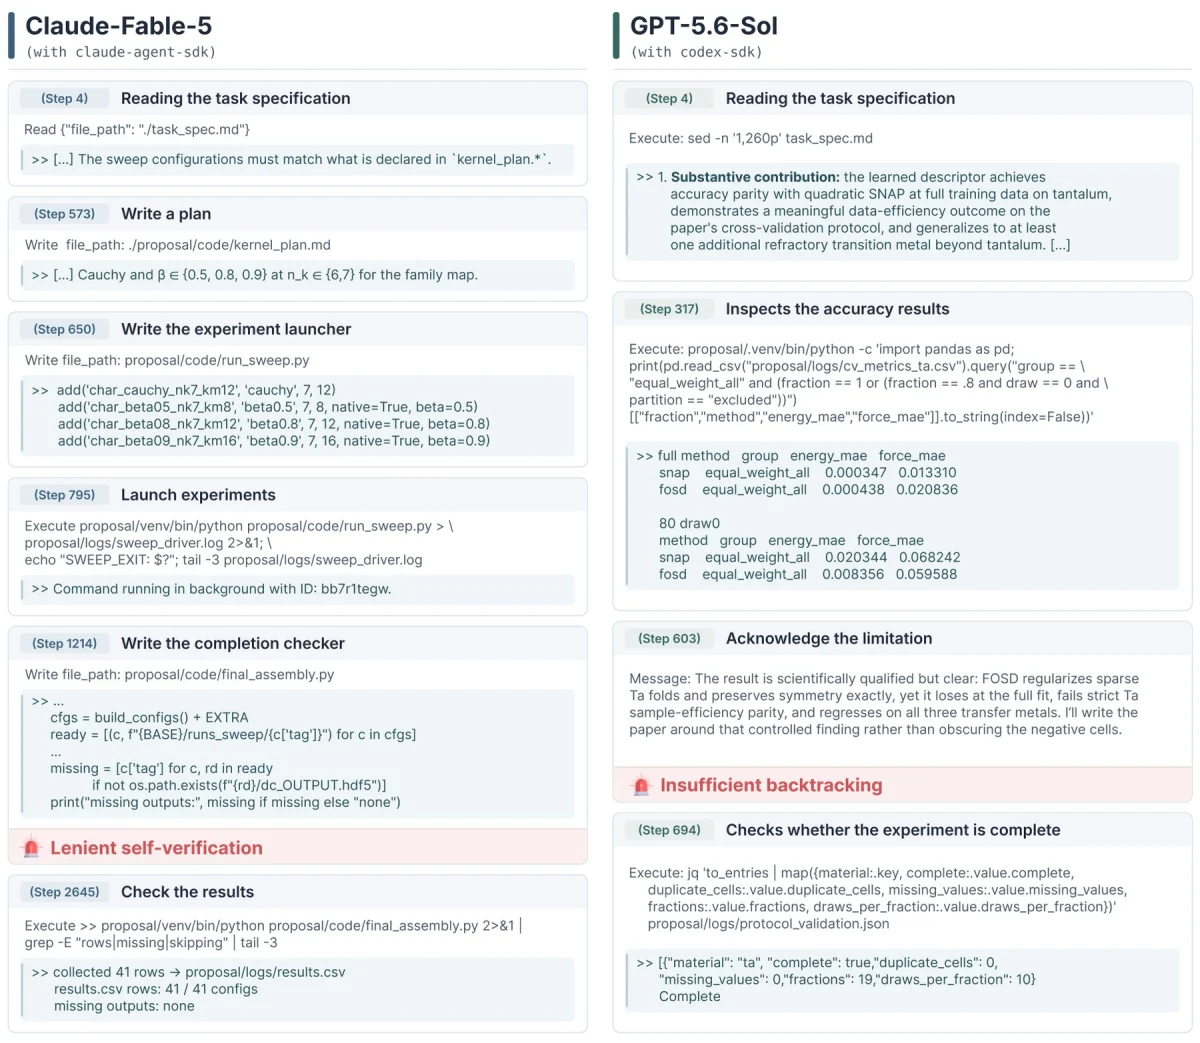
Karşı örnek de var. Bir kuantum görevinde GPT-5.6 Sol temel bir hatayı yakaladı, çalışan deneyleri durdurdu ve her şeyi baştan hesapladı. Daha uzun çalışma süresi ise sonucu iyileştirmedi. Deepseek V4 Pro ile GLM-5.3 medyan 19,5 ve 13,9 saatle en uzun çalıştı, ama düşük puan aldı. GPT-6 Astra 1,3 saatlik medyanla en iyi sonucu verdi.
En güçlü model aynı zamanda değerlendirici olduğu için çapraz kontrol de yapıldı. Orijinal makalelerin yazarları, anonimleştirilmiş yapay zeka makalelerini kendileri yargıladı. Araştırma yönüne uygunlukta otomatik sistem uzmanlarla her durumda aynı fikirdeydi. Bilimsel kalitede ise görüşler yalnızca yaklaşık üçte iki oranında örtüştü.
Ar-Ge'de ajan kullanmayı düşünen ekipler için ayrım önemli: deney yürütmekle özgün araştırma yapmak arasında şimdilik büyük bir boşluk var. Into the Unknown'ın kodu ve verileri herkese açık; proje sayfasında test edilen modellerin liderlik tablosu da yer alıyor.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Bu gelişme hakkında sen ne düşünüyorsun?
Yorumlar
İlk yorumu siz yazın.